
补丁明明打了,为什么企业终端依然存在安全风险?
2026-11-04 07:36分享
很多企业每个月都在打补丁,但如果问一句:现在有多少台终端存在高危漏洞?哪些漏洞还没有修复?哪些设备已经失去维护支持?可能并不是每个企业都能马上回答,问题并不在于企业没有开展漏洞管理,而在于漏洞管理很容易停留在“扫描一次、生成一份报告、通知相关人员修复”的阶段,报告有了,台账有了,整改通知也发了,但风险真的消除了吗?这才是企业漏洞治理需要关注的核心问题。
Ø 漏洞不可怕,可怕的是不知道风险在哪里
在企业环境中,终端数量往往比较庞大,除了常见的办公电脑,还有服务器、生产终端、营业终端、专用设备以及各种不同版本的操作系统;不同设备的软件版本、补丁状态和业务重要性各不相同。这会带来几个现实问题。
- 资产不清,扫描就容易留下盲区:如果某台终端没有纳入统一管理,漏洞扫描再完善,也可能无法覆盖这台设备。
- 漏洞很多,却不知道应该先修哪个:漏洞数量并不等于实际风险。同样是高危漏洞,是否存在公开利用代码、设备是否暴露在高风险网络中、是否承载重要业务,都会影响处置优先级。
- 补丁下发了,不代表补丁安装成功:终端可能处于离线状态,也可能因为磁盘空间不足、软件冲突或重启要求,导致补丁未能完成安装。
- 修复完成了,也不代表风险已经闭环:如果缺少修复后的复测与验证,就无法准确判断漏洞是否真正消除。所以,漏洞治理的难点不是简单地找出漏洞,而是确保风险被识别、被评估、被修复,并得到验证。
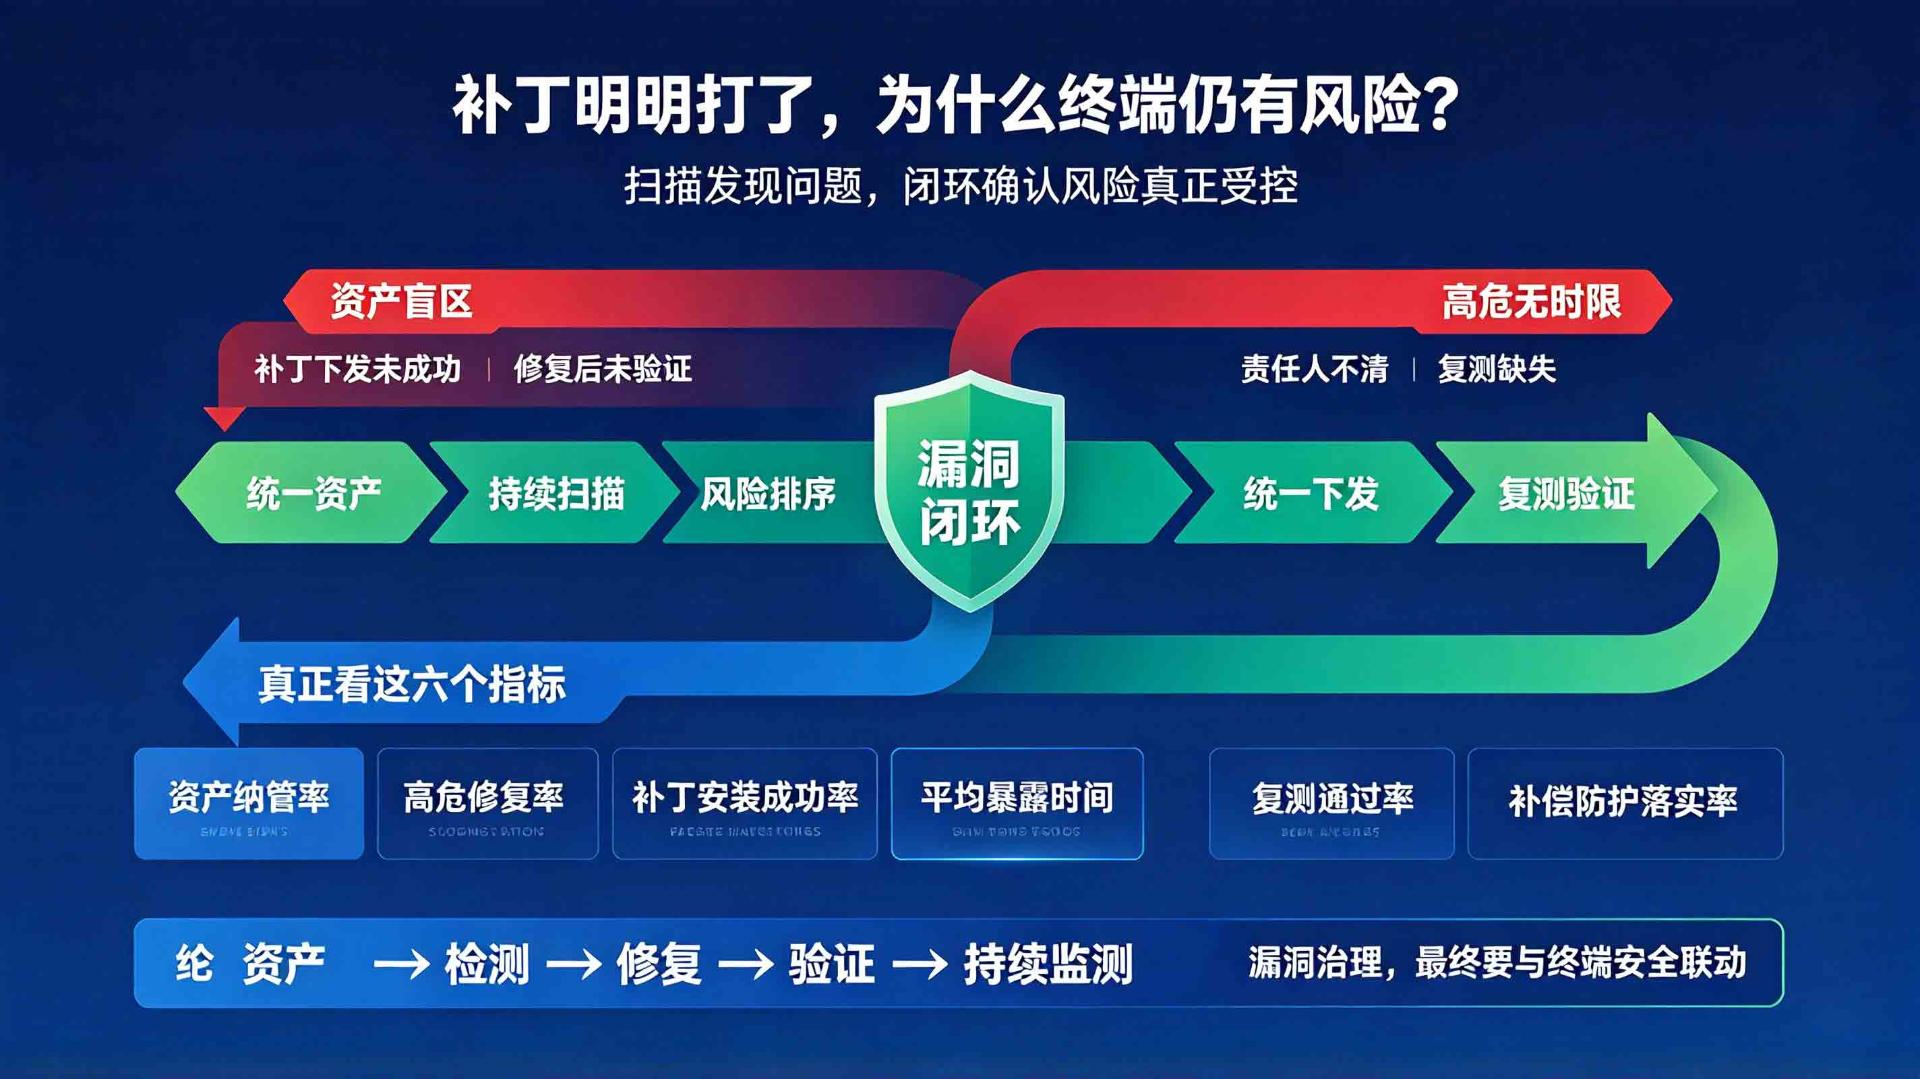
Ø 从漏洞扫描到漏洞闭环,究竟差在哪里
传统的漏洞管理流程通常是:扫描终端、输出报告、分派整改、等待反馈。这套流程能够发现问题,但如果依赖人工推进,容易出现几个断点:
- 扫描结果与实际终端资产无法持续对应。
- 高危漏洞没有明确的整改时限和责任人。
- 补丁下发后缺少统一的执行状态监测。
- 业务终端担心兼容性问题,迟迟不敢安装补丁。
- 整改完成后没有及时复测,台账长期处于不准确状态。
真正有效的漏洞管理,应当从一次性任务升级为持续性的风险治理机制。
- 第一步:统一资产,明确管理对象:建立终端资产台账,持续采集操作系统、软件版本、设备状态和补丁信息。只有先知道有哪些设备、设备运行什么软件,才能准确判断漏洞影响范围。
- 第二步:持续扫描,发现风险:通过漏洞扫描、版本检测和补丁状态检查,识别终端中的已知漏洞及未修复问题,对不同来源的检测结果进行归并,减少重复告警,提升风险管理效率。
- 第三步:风险排序,优先处理真正危险的问题:综合考虑漏洞严重程度、实际利用情况、终端重要性、网络暴露情况和业务影响,制定差异化修复计划。高风险资产优先处理,普通风险按计划推进,暂时无法修复的漏洞则应配置适当的缓解措施。
- 第四步:统一下发,跟踪执行状态:通过补丁管理能力统一编排补丁分发与安装任务,监测任务下发、安装结果、失败原因和必要的重启状态。针对重要生产终端,应先验证补丁兼容性,采用分批部署和回退预案,避免修复漏洞引发业务中断。
- 第五步:复测验证,形成整改闭环:补丁安装完成后,重新检查漏洞状态,核实风险是否消除。对于无法修复的设备,应记录原因、责任人、临时防护措施和后续计划,确保风险始终处于可管理状态。
Ø 漏洞管理不应该只看扫描数量:
有些安全管理工作习惯用扫描次数、漏洞发现数量来衡量成效。但从风险治理的角度来看,更值得关注的是:
- 终端资产纳管率是多少?
- 高危漏洞按期修复率是多少?
- 补丁安装成功率是多少?
- 高危漏洞平均暴露时间有多长?
- 整改完成后复测通过率是多少?
- 暂时无法修复的漏洞是否落实了补偿性防护措施?
这些指标更接近企业真正关心的问题:风险是否减少,整改是否有效,安全管理是否能够持续运行。
Ø 漏洞治理,最终需要与终端安全联动
漏洞管理并不是孤立的功能,当漏洞扫描发现某台终端存在高风险问题时,可以进一步关联该终端的资产信息、运行状态和安全告警,判断其是否正在遭受攻击。如果EDR同时发现异常进程、可疑网络连接或漏洞利用相关行为,就可以提高风险优先级,推动安全人员进行调查和处置。对于无法立即修复的漏洞,也可以根据业务条件采取网络访问限制、应用控制、攻击行为监测等临时措施。这样,漏洞管理就不再只是定期生成报告,而是成为终端安全运营的一部分。
漏洞扫描解决的是“发现问题”,补丁管理解决的是“推动修复”,而漏洞闭环解决的是“确认风险真正得到控制”。
对于企业而言,只有把资产、检测、修复、验证和持续监测连接起来,漏洞治理才能从被动整改走向主动防御。
推荐阅读
相关新闻



粤ICP备2026035979号-1 Copyright All Rights Reserved ©2025和中通信科技有限公司版权所有,和中通信科技有限公司简称【和中科技】