传统 XSS 的生命周期:用户关闭页面,攻击结束。
但现代浏览器给了攻击者太多"活过页面关闭"的能力——Service Worker、扩展通信、缓存、后台同步。
当 XSS 不再是"一次性"的,检测的重点也必须从"输入过滤"转向"运行时异常发现"。
这篇文章不讨论怎么利用这些攻击面。讨论的是:如果它们正在发生,你从哪些信号能发现。
现代浏览器攻击面的共同特征不是"新漏洞",而是浏览器自身提供的合法机制被滥用。 Service Worker 是合法的,扩展消息通道是合法的,DNS 解析是合法的,PDF 里的 JavaScript 也是合法的。 正因为它们是合法机制,检测不能靠"黑名单",只能靠"基线偏离"。
一、为什么检测视角和传统 XSS 完全不同
传统 XSS 检测的核心是"输入里有没有恶意字符"。这条路在现代攻击面前基本失效:
- 攻击 payload 不在你的输入里。Service Worker 是浏览器 API 注册的,不是表单提交的。
- 持久化发生在浏览器端,不在服务器端。你修好了 XSS 漏洞,已经注册的 Service Worker 不会消失[reference:0]。
- 攻击面横跨浏览器、扩展、本地网络。一个检测规则覆盖不了。
所以检测视角需要从"输入验证"转向"浏览器运行时行为基线": 你的应用在正常状态下会注册几个 Service Worker、会向哪些扩展发消息、会向哪些私有 IP 发请求。 偏离这个基线的,就是信号。
二、Service Worker:最需要被"监控"的攻击面
持久化 · 高优先级Service Worker 劫持
Service Worker 一旦注册成功,会跨浏览器会话存活,拦截它 scope 下的每一个请求, 修改请求和响应,读写 Cache[reference:1]。它的威胁不是"当前页面被篡改", 而是"即使服务器已经修复,用户浏览器里那个恶意 SW 还在工作"[reference:2]。
检测信号
- 注册基线偏移:你的应用正常情况下应该只有一个特定 scope 的 SW。 如果在其他 scope 出现注册,或者在非预期脚本 URL 上出现注册, 这是最直接的信号[reference:3]。
- SW 脚本来源异常:SW 的 script URL 如果不是你的受控域/CDN, 或者通过
importScripts()引入了未知第三方脚本,说明供应链或注入路径可能被打开[reference:4]。 - 客户端行为突变:SW 注册后,页面发出的请求模式会变化(新增中间层、缓存命中率异常、响应内容被修改)。 客户端监控可以标记"新的 worker 行为"[reference:5]。
- 更新被阻断:恶意的 SW 可以拦截对自身更新脚本的请求,返回旧版本,阻止合法更新覆盖[reference:6]。 如果你的发布流程中 SW 更新反复失败或版本号不前进,需要排查。
防御方应该做的
- 把所有 SW 注册事件上报到服务端,做异常检测——注册了哪些 scope、script URL 是什么、来自哪个页面[reference:7]。
- 在应用侧实现 SW 清单:明确哪些 scope、哪些脚本 URL 是预期的,其余一律告警。
- 定期检查浏览器端已注册的 SW(比如通过管理扩展或企业策略),发现孤儿 SW 主动清理。
三、DOM Clobbering:被代码逻辑"信任"的隐患
逻辑绕过 · 中优先级DOM Clobbering
DOM Clobbering 的本质不是"执行了恶意脚本",而是页面自己的代码信任了不该信任的全局属性。 比如代码写了 if (window.config.admin) { ... }, 而攻击者通过注入 <form id="config"><input name="admin" value="true"></form> 让 window.config.admin 意外为真。
检测信号
- 代码审计中的隐式全局依赖:搜索
window.xxx、document.xxx直接作为对象使用的地方,尤其是后面跟着.admin、.config、.token这类敏感属性。 - HTML 注入点的属性白名单缺口:如果 HTML 净化允许
id和name属性, 但没有隔离命名空间,DOM Clobbering 的条件就成立。
防御方应该做的
- 用 Trusted Types 强制类型约束:CSP 的
require-trusted-types-for 'script'会让浏览器拒绝把普通字符串赋给innerHTML等危险 sink[reference:8]。 这对 DOM XSS 是浏览器层面的强制缓解[reference:9]。 - 净化库开启命名空间隔离:DOMPurify 有 DOM Clobbering 保护选项, 通过 namespace isolation 降低
id/name被滥用为全局属性的可能[reference:10]。 - 代码层面停止隐式全局依赖:不要写
window.config,写显式的AppConfig.get('admin'),把"信任"收敛到受控的命名空间里。
四、浏览器扩展:合法通道被当成跳板
权限滥用 · 高优先级扩展通信暴露
这不是"扩展本身有漏洞",而是扩展把 externally_connectable 开得太宽, 又没有校验发送者来源。 一个真实的案例:扩展的 externally_connectable.matches 设为 ["http://*/*", "https://*/*"], 后台 onMessageExternal 不验证 sender origin,任何网页都能触发扩展去抓取任意 URL[reference:11]。
检测信号
- Manifest 中的宽匹配:审计所有扩展的
externally_connectable.matches。 如果看到http://*/*或https://*/*,这就是一个需要重点审查的暴露面[reference:12]。 - 外部消息处理器缺少来源校验:搜索
onMessageExternal的回调里有没有sender.origin/sender.url的白名单检查。 没有校验的,就是 confused deputy 的候选[reference:13]。 - 扩展被用于访问非预期目标:如果扩展的日志里出现大量非用户主动发起的 URL 访问(尤其是内网地址、认证后的页面),说明它可能正在被外部网页驱动[reference:14]。
防御方应该做的
externally_connectable.matches只允许受控的自家域,不要用通配[reference:15]。- 所有外部消息处理前强制校验 sender origin,不在白名单里的直接拒绝[reference:16]。
- 不要把"打开任意 URL 并抓取"的能力暴露给外部消息——如果需要,目标 URL 必须由扩展侧根据可信上下文决定,而不是外部传入[reference:17]。
五、DNS 重绑定:同源策略的"时间差"
网络边界绕过 · 中优先级DNS 重绑定
DNS 重绑定的核心是利用浏览器对 DNS 的信任和短 TTL: 域名第一次解析到攻击者服务器,加载恶意页面;TTL 过期后,同一域名解析到内网 IP。 浏览器认为"还是同一个源",于是恶意 JS 可以向内网发请求[reference:18]。
检测信号
- 服务端 Host 头校验缺失:如果你的内网服务只监听 IP、不校验 HTTP Host, 重绑定过来的请求看起来"合法"。
- 一个域名同时解析到公网和私有 IP:这是 DNS 重绑定的典型特征。 可以用 DNS 查询工具定期检查你的域名是否出现这种双解析[reference:19]。
- 来自浏览器的请求突然访问内网服务:内网服务通常只接受内网来源, 但如果请求的
Referer或Origin是一个外部域名,这是一个强信号。
防御方应该做的
- 服务端强制 Host 头校验:只接受预期的 Host 值,拒绝不在白名单里的
Host[reference:20]。 - 启用 Private Network Access(PNA):现代浏览器在外部源访问私有 IP 时会发送预检, 服务端应该正确响应 PNA 预检,而不是忽略它[reference:21]。
- 内网服务默认要求认证:不要因为"来自内网"就跳过认证。 DNS 重绑定把浏览器变成了内网代理,浏览器发起的请求在服务端看起来和正常内网请求没有区别[reference:22]。
六、PDF 与 WebSocket:两条"绕过 CSP 直觉"的路径
内容通道 · 中优先级PDF 内嵌 JavaScript & WebSocket
PDF 内嵌 JavaScript
扩展名校验和 Content-Type 都不足以拦住恶意 PDF。 真正的检测必须看文件内容:PDF 里是否包含 /JavaScript 或 /JS 关键字[reference:23]。
- 检测信号:上传的 PDF 中出现
/JavaScript、/JS、/OpenAction等主动内容标记。 - 防御:上传侧用 magic-byte 确认真实类型,然后用 PDF 解析库(如 PDFBox)扫描主动内容; 如果业务不需要脚本,直接剥离或拒绝带 JavaScript 的 PDF[reference:24][reference:25]。
WebSocket 与 CSP
CSP 的 connect-src 理论上可以限制 WebSocket,但实践中容易出现两个问题: 一是配置成了 connect-src 'self' ws: wss:,过于宽泛; 二是某些浏览器/沙箱场景下,混合内容或未加密的 WebSocket 没有被严格阻断[reference:26][reference:27]。
- 检测信号:CSP 的
connect-src里出现ws:(未加密)或宽泛的wss:。 如果业务不需要 WebSocket,这是一个可以直接收紧的点。 - 防御:
connect-src只允许具体的 WebSocket 端点, 而不是整个ws:/wss:scheme[reference:28]。
七、侧信道与 RCE:不是"应用漏洞",但需要纳入基线
底层风险 · 基线检查SharedArrayBuffer 侧信道 & 类型混淆 RCE
这两类严格来说不是"你的代码有洞",而是浏览器引擎和硬件层面的风险。 检测视角的重点不是"发现攻击",而是确认缓解措施是否在位。
SharedArrayBuffer 侧信道
高精度计时 + SharedArrayBuffer 可以构成缓存侧信道。 现代浏览器的缓解方式是跨源隔离: SharedArrayBuffer 只有在 COOP + COEP 头都设置、crossOriginIsolated === true 时才可用[reference:29][reference:30]。
- 基线检查:如果你的站点不需要
SharedArrayBuffer, 就不应该返回 COOP/COEP——返回了反而说明某个功能在依赖它。 如果需要,确认crossOriginIsolated为 true,并且计时器精度已被浏览器量化[reference:31]。
类型混淆 RCE
V8 等引擎的类型混淆漏洞一旦被利用,可以在浏览器沙箱内实现任意读写,进一步逃逸到 RCE[reference:32]。 检测方能做的主要是确保缓解层没有缺失:
- Site Isolation 是否启用(
chrome://process-internals)[reference:33]。 - 浏览器是否在最新补丁版本(类型混淆零日通常有明确的版本门槛)[reference:34]。
- 沙箱、非管理员运行、Web 过滤等纵深措施是否在位[reference:35]。
这些不是"应用层检测规则",而是终端安全基线和浏览器管理策略的一部分。
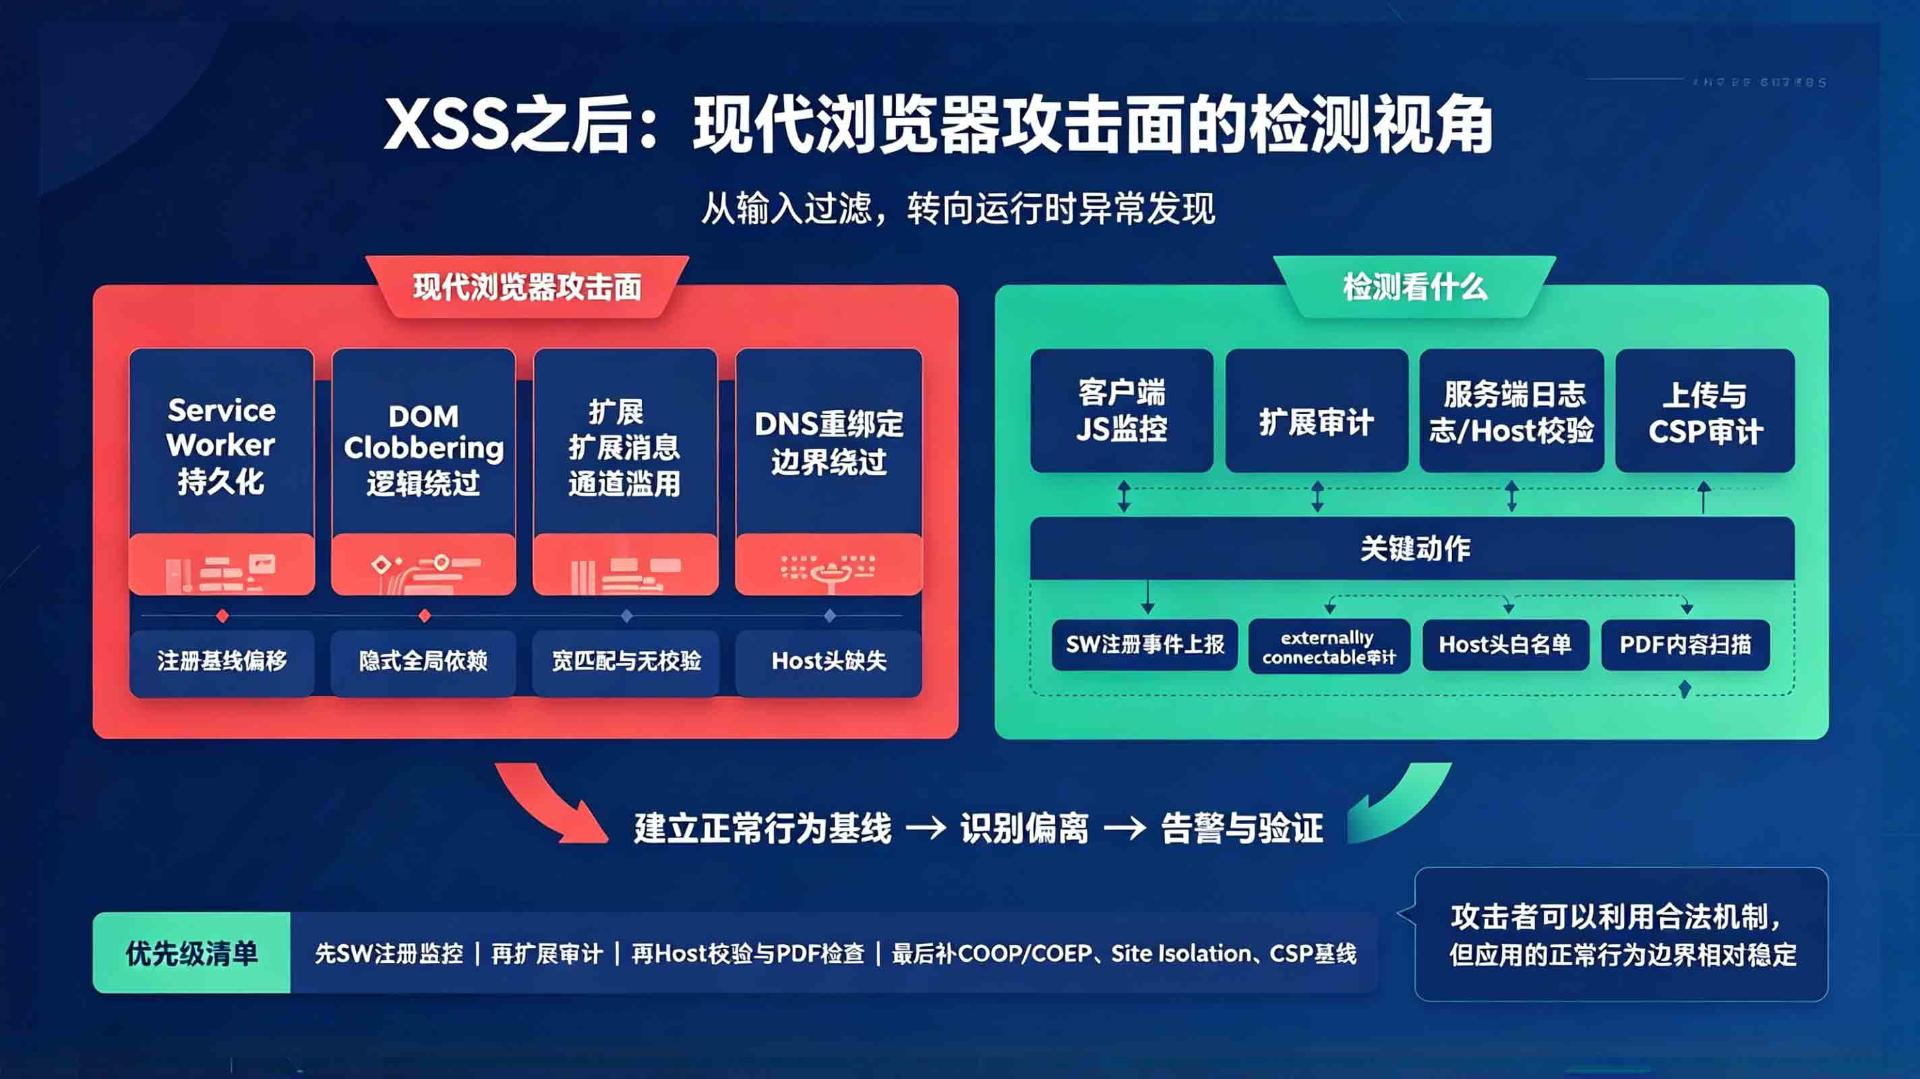
八、把检测点串成一张"浏览器攻击面检测清单"
上面的攻击面分散在不同的层:应用代码、扩展、网络、文件上传、终端策略。 对防御方来说,最有操作性的方式不是"每个攻击面写一条 YARA",而是按数据源归集检测能力。
| 数据源 | 能覆盖的攻击面 | 关键检测动作 |
|---|---|---|
| 客户端 JS 监控 / RUM | Service Worker 注册、DOM Clobbering 的注入迹象 | 上报 SW 注册事件(scope + script URL);监控 id/name 属性注入导致的全局属性变化 |
| 扩展审计 | externally_connectable 滥用 | 清单中宽匹配告警;外部消息处理器缺少来源校验告警 |
| 服务端访问日志 / Host 校验 | DNS 重绑定 | 拒绝非白名单 Host;记录来自外部 Origin 的内网访问尝试 |
| 文件上传管线 | PDF 内嵌 JavaScript | magic-byte 确认类型 + PDF 内容扫描 /JavaScript / /JS |
| CSP 报告 / 配置审计 | WebSocket 宽泛、Trusted Types 缺失 | 检查 connect-src 是否包含 ws:;检查是否启用 require-trusted-types-for |
| 终端 / 浏览器管理 | 侧信道与 RCE 的底层缓解 | Site Isolation、补丁级别、非管理员运行、沙箱状态 |
九、一个可操作的"成熟度"视角
如果你的团队现在才开始建立浏览器侧的检测,不建议一次性把所有攻击面都覆盖。 按"攻击者获得持久控制的速度"排序,优先级是:
- 先覆盖 Service Worker 注册监控。 这是唯一一个"XSS 修好之后攻击者还能继续控制"的攻击面, 且检测成本很低——只需要把注册事件上报[reference:36]。
- 再审计扩展的 externally_connectable。 这是静态配置,审计一次就能消除一批暴露面[reference:37]。
- 然后补 Host 校验和 PDF 内容检查。 这两个属于常规安全卫生,实现成本低,能拦住"把浏览器当代理"和"带脚本的文档"两类问题[reference:38][reference:39]。
- 最后确认 COOP/COEP、Site Isolation、CSP 的
connect-src收口。 这些是基线,不是"发现攻击"的工具,但缺失会让前面的努力打折扣。
Service Worker 和扩展滥用的检测,不能只在服务器端做。 SW 是浏览器 API,扩展消息是浏览器内部通道,服务器看不到这些动作。 客户端监控(或企业浏览器管理策略)是必须的补充数据源[reference:40]。
十、写在最后
现代浏览器攻击面的检测,本质上不是"找新的攻击特征",而是建立并持续验证"正常行为基线":
- 正常情况下,我的应用注册几个 SW、scope 是什么?
- 正常情况下,我的扩展应该接受来自哪些源的消息?
- 正常情况下,我的内网服务应该看到什么样的 Host 头?
- 正常情况下,我的上传管线应该允许哪些主动内容?
偏离基线的地方,就是需要深入的地方。这比维护一张"恶意 payload 特征表"更可持续—— 因为攻击者可以利用的合法机制会越来越多,但你的应用正常行为的边界是相对稳定的。
- Service Worker 注册事件上报 + scope/URL 基线告警
- 扩展 externally_connectable 宽匹配审计 + 外部消息来源校验
- 内网服务强制 Host 头白名单
- PDF 上传内容扫描(/JavaScript、/JS)
- CSP connect-src 收紧(移除宽泛 ws:/wss:)
- Trusted Types 或净化库命名空间隔离(针对 DOM Clobbering)
- COOP/COEP、Site Isolation、补丁级别的定期基线验证